
Content
Plugin
thesis-creator
面向中国本科生的毕业论文全流程写作辅助系统 从选题到交稿,一句话搞定 功能特性 • 快速开始 • 使用文档 •

Plugin Signal39/100Fair
maintained49
capable14
documented50
adopted50
Install
$ npx -y skills add Stars-OC/thesis-creator --agent claude-code
Stats
222
Stars
8
Forks
Maintained
Maintenance
Python
Language
MIT
License
3mo ago
Last commit
6mo ago
Created
Repo: Stars-OC/thesis-creator
What's inside
README
论文创作 Agent 系统
面向中国本科生的毕业论文全流程写作辅助系统
从选题到交稿,一句话搞定


简介
论文创作 Agent 系统是一个基于 Claude Code 的毕业论文写作辅助工具。通过智能化的 10 步工作流,帮助本科生高效完成毕业论文创作,同时提供降重优化、AIGC 检测和文献真实性验证功能。
[!IMPORTANT] v2.0 多学科 Beta 预告:
main当前默认支持 CS / SE 学科。 已在multi-discipline-beta分支提供 9 个学科模板包(计算机/经管/法学/教育/人文/医护/工科/理科/艺术设计)+ 状态机产物对账 + 图片管线双格式。 教育学测试用例已端到端跑通(Step 0→9 全部 completed,AIGC 6.1%)。 完整路线请见 docs/ROADMAP.md。
功能特性
| 特性 | 说明 |
|---|---|
| 🔄 全流程覆盖 | 从选题到交稿的端到端工作流 |
| 📉 降重优化 | 句式重构、同义替换、段落重组 |
| 🤖 AIGC 降低 | 场景化重写、自然承接、轻冗余控制和高密度句拆解,降低模板化与机械表达特征 |
| 🔗 自然承接语 | 压缩模板化连接词,允许“具体来说、换句话说、放到实际使用里看”等解释型转场 |
| 🪶 轻冗余控制 | 删除机械废话,保留少量“通常、往往、也会、在一定程度上”等缓冲词 |
| 🧩 高密度句拆解 | 将职责、流程、目标塞在一句内的内容拆成主干、动作和解释层 |
| 📚 成语适度使用 | 仅在非技术性总结或维护效果说明处少量使用,避免技术细节附近堆砌 |
| 🔍 本地检测 | 轻量级 AIGC 检测工具,快速预估检测率 |
| 📝 格式检查 | 自动检查论文结构规范性 |
| 💬 智能讨论 | 三轮深入讨论充分理解论文需求 |
| 🖼️ 图片生成 | 从图片需求清单生成 Mermaid、Graphviz、PlantUML 图表;系统架构图和截图按用户图片占位处理 |
| 📄 图片插入 | Word 文档自动插入图片和图注 |
| 📚 文献验证 | 三源学术搜索 + DOI 验证 + 虚构文献自动替换 ⭐ NEW |
| ⚙️ 配置化 | YAML 配置文件,API Key / 日志 / 导出格式可配置 ⭐ NEW |
| 📝 摘要生成 | 自动生成中英文摘要与关键词 ⭐ NEW |
| 📊 文档导出 | 支持 Word/PDF 格式一键导出 |
AIGC 降低效果展示
改写示例
检索增强生成(Retrieval-Augmented Generation,RAG)技术的出现,为解决上述问题提供了有效方案。RAG通过将检索系统与大模型结合,使模型能够基于特定知识库生成回答,显著提升了回答的准确性和可靠性。
从实践角度看,中小企业在部署AI知识库时面临诸多挑战。商业化的企业级知识管理产品往往价格昂贵、部署复杂,难以满足中小企业的实际需求。开源方案虽然成本较低,但技术门槛高、集成难度大
。因此,设计一个技术成熟、部署灵活、成本可控的AI知识库系统,对推动中小企业数字化转型具有重要的实践意义。
国内外研究现状
知识管理领域的研究始于20世纪90年代。Nonaka于1995年提出的SECI知识创造模型,系统阐述了隐性知识与显性知识的转化过程,为后续研究奠定了理论基础[3]。进入21世纪后,随着互联网技术的发展
,知识管理系统的研究重心逐渐从理论框架转向技术实现。
在知识表示与存储方面,知识图谱(Knowledge Graph)技术成为研究热点。2012年,Google正式发布知识图谱项目,将其应用于搜索引擎优化。此后,Facebook、Amazon、Microsoft等科技公司相继推
出类似产品。知识图谱通过结构化的方式表示实体及其关系,使机器能够"理解"知识语义,为智能问答提供了有力支撑[4]。学者们围绕知识图谱的构建方法、存储优化、推理机制等展开了深入研究。Bo
rdes等人提出的TransE模型开创了知识图谱嵌入学习的先河,后续的TransH、TransR等模型进一步提升了表示学习的效果[5]。
在智能问答方面,早期的研究主要基于关键词匹配和模板填充。随着深度学习技术的发展,基于神经网络的问答系统逐渐成为主流。2017年,Vaswani等人提出的Transformer架构引发了自然语言处理领
域的范式变革[6]。基于Transformer的预训练模型,如BERT、GPT系列,在问答任务上取得了突破性进展。2022年,ChatGPT的发布更是将智能问答推向了新的高度。
RAG技术的提出解决了大模型在专业领域应用中的知识局限性问题。Lewis等人于2020年首次系统阐述了RAG框架,通过引入外部知识库增强模型的生成能力[7]。此后,众多学者对RAG进行了改进和优化。
Karpukhin等人提出的DPR(Dense Passage Retrieval)方法,利用双塔编码器实现高效的语义检索[8]。Gao等人探索了RAG在医疗、法律等专业领域的应用,验证了其在垂直场景的有效性[9]。
纵观国内外研究现状,知识库系统的发展呈现出以下特点:
其一,技术架构从单一存储向多元融合演进。现代知识库系统不仅支持结构化数据和非结构化文档的统一管理,还融合了向量检索、图数据库等新技术,实现了多模态知识的高效组织。
其二,智能化程度不断提升。从早期的关键词搜索到语义检索,从简单的问答对匹配到大模型驱动的智能对话,知识库系统的交互方式日益智能化。
其三,部署模式趋于灵活。云原生架构、微服务设计的普及,使得知识库系统能够根据企业规模和需求灵活部署,降低了中小企业的使用门槛。
然而,现有研究和产品仍存在一定不足:部分商业产品价格高昂,中小企业难以承受;开源项目技术门槛较高,需要较强的研发能力;现有系统在知识图谱自动化构建、多源知识融合等方面的能力有待
提升。本研究将在现有技术基础上,设计一个适合中小企业部署的轻量级AI知识库系统
研究内容
本文围绕AI知识库系统的设计与实现展开研究,主要内容包括:
(1)系统架构设计。研究适合中小企业部署的系统架构,采用前后端分离、微服务设计思想,确保系统的可扩展性和可维护性。
(2)核心技术实现。深入研究RAG架构、向量检索、知识图谱等核心技术,设计合理的实现方案。
(3)功能模块开发。实现用户管理、知识库管理、智能问答、知识图谱、系统配置等功能模块,满足企业的实际业务需求。
(4)系统测试与优化。对系统进行功能测试和性能测试,验证系统的正确性和稳定性。
但实践层面,中小企业部署AI知识库并非一帆风顺。商业化产品动辄数十万,部署也颇为复杂;开源方案虽然免费,技术门槛却高不可攀,集成起来困难重重。这便是本研究的出发点:设计一个技术成熟、部 署灵活、成本可控的AI知识库系统,为中小企业数字化转型提供切实可行的路径。
国内外研究现状
知识管理研究起点可以追溯到20世纪90年代。Nonaka在1995年提出SECI模型,系统揭示了隐性知识与显性知识转化机制,后来者多有沿袭[3]。进入21世纪,互联网技术突飞猛进,研究重心也随之从理论框架 转向技术落地。
知识图谱的兴起是一个重要节点。2012年Google正式发布知识图谱项目后,Facebook、Amazon、Microsoft等科技巨头紧随其后。知识图谱用结构化方式表示实体及其关系,机器因此能够"理解"知识语义,智 能问答有了坚实根基[4]。围绕知识图谱的构建方法、存储优化、推理机制等,学者们展开了较为深入的研究。Bordes等人提出的TransE模型开创了知识图谱嵌入学习先河,后续的TransH、TransR等模型又将 表示学习效果推上新台阶[5]——这几篇论文在当时被引用得相当多。
智能问答的演进同样耐人寻味。早期方案依赖关键词匹配和模板填充,粗糙而僵化。深度学习入场后,基于神经网络问答系统逐渐成为主流。2017年是转折点——Vaswani等人提出的Transformer架构颠覆了自然 语言处理既有范式[6]。BERT、GPT等预训练模型相继涌现,问答任务取得长足进步。2022年ChatGPT发布,更是将智能问答推向公众视野中心。
RAG技术则在另一个维度上发力:它解决的是大模型在专业领域的知识短板。根据Lewis等人(2020)的阐述,RAG框架通过引入外部知识库来增强模型生成能力[7]。此后改进方案层出不穷:Karpukhin等人提 出DPR方法,用双塔编码器实现高效语义检索[8];Gao等人则在医疗、法律等领域验证了RAG实战价值[9]。
纵观研究现状,知识库系统演进呈现出几条清晰脉络。技术架构层面,从单一存储走向多元融合——现代知识库系统既能管理结构化数据,也能处理非结构化文档,向量检索、图数据库等技术引入让多模态知识 组织更加高效。智能化程度持续深化,交互方式也从关键词搜索升级为语义检索,从问答对匹配进化为大模型驱动智能对话。部署模式日趋灵活,云原生架构和微服务设计逐渐普及,中小企业可以根据自身规 模和需求灵活部署。
当然,现有研究和产品仍有短板。商业产品价格令人望而却步;开源项目对研发能力要求较高;知识图谱自动化构建、多源知识融合等能力也还有提升空间。本研究将在现有技术基础上,设计一个适合中小企 业部署的轻量级AI知识库系统。
研究内容
本文围绕AI知识库系统设计与实现展开研究,主要工作包括:
(1)系统架构设计。针对中小企业部署场景,采用前后端分离、微服务设计思想,兼顾可扩展性与可维护性。
(2)核心技术实现。围绕RAG架构、向量检索、知识图谱等关键技术,设计切实可行的实现方案。
(3)功能模块开发。完成用户管理、知识库管理、智能问答、知识图谱、系统配置等模块开发工作。
(4)系统测试与优化。开展功能测试和性能测试,验证系统正确性与稳定性。
策略应用说明
| 策略 | 应用前后对比 |
|---|---|
| 场景化重写 | 先判断段落功能,从真实使用场景切入,而不是只替换词语 |
| 自然承接语 | 压缩「此外、综上所述」等模板连接,保留“具体来说、换句话说”等解释型转场 |
| 轻冗余控制 | 保留少量“通常、往往、也会”等缓冲词,避免文本被压缩得过于生硬 |
| 高密度句拆解 | 将职责、动作、目标集中的长句拆成主干句、动作说明和解释层 |
| 条款结构保护 | 保留(1)(2)(3)等编号、标题和顺序,只改条款内部表达 |
| 学术边界 | 不新增虚构接口、表结构、实验指标或参考文献,避免口语化和宣传化 |
📌 AIGC检测率对比
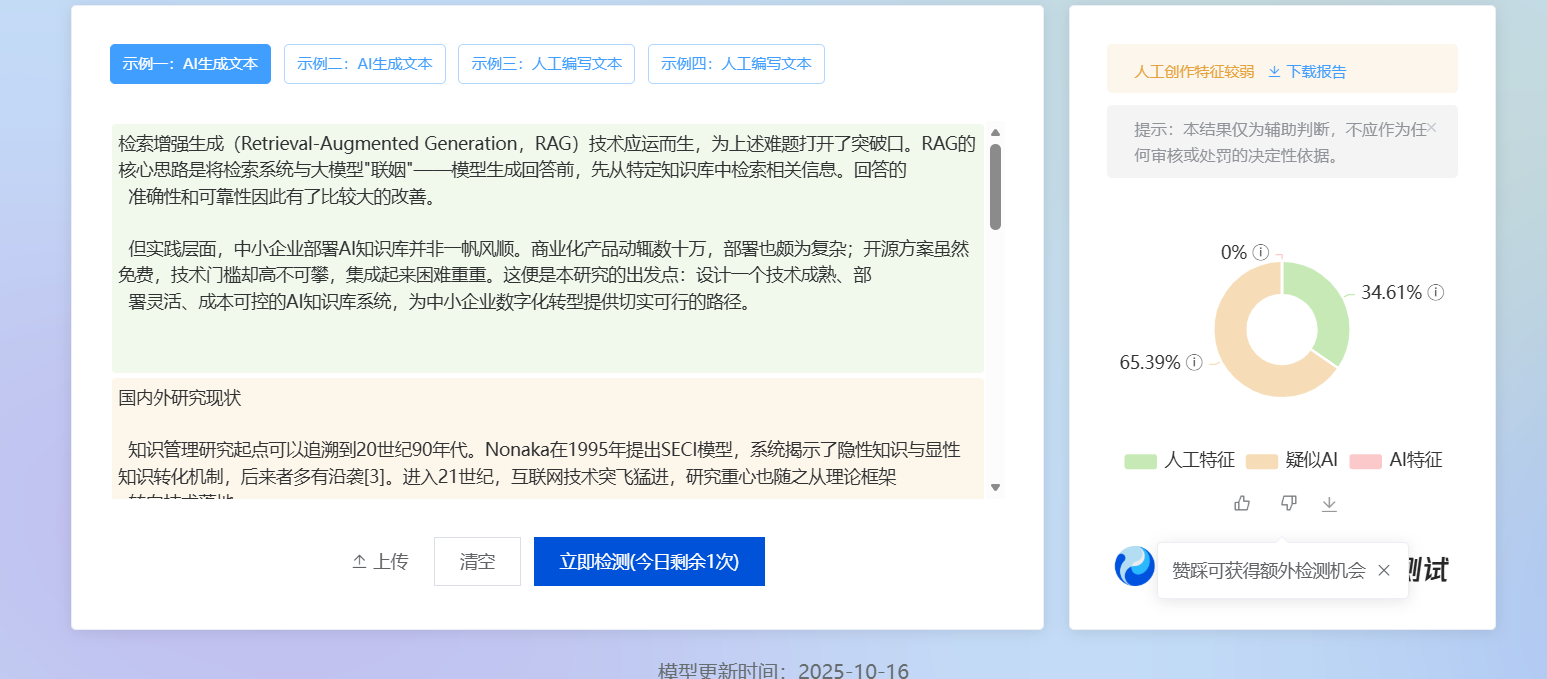
⚠️ 重要提示
[!WARNING] 关于 AIGC 降低的客观认知
降低检测率的同时,文本可能会失去部分学术严谨性。
- 成语替换可能让学术表达显得稍显文学化
- 「的」字删除需谨慎处理,过长定语保留可读性
- 微瑕疵模拟不应影响核心论点的逻辑清晰
- 不同学科对成语接受度不同,请参考学科适配表
建议:将降重视为辅助工具,最终内容需人工审核确保学术质量。
工作流程
┌─────────────────────────────────────────────────────────────┐
│                      论文创作工作流                           │
├─────────────────────────────────────────────────────────────┤
│  Step 0: 初始化工作区                                        │
│      ↓                                                       │
│  Step 1: 环境准备  →  Step 1.5: 背景信息讨论                  │
│      ↓                                                       │
│  Step 2: 读取参考资料  →  Step 3: 生成论文大纲                │
│      ↓                                                       │
│  Step 4: 分章节撰写(含摘要生成)→  Step 5: 降重处理           │
│      ↓                                                       │
│  Step 6: AIGC 人性化  →  Step 7: 合并检测                     │
│      ↓                                                       │
│  Step 8: 图片生成与渲染 🖼️                                   │
│      ↓                                                       │
│  Step 9: 文档导出(Word/PDF + 图片插入)                      │
└─────────────────────────────────────────────────────────────┘
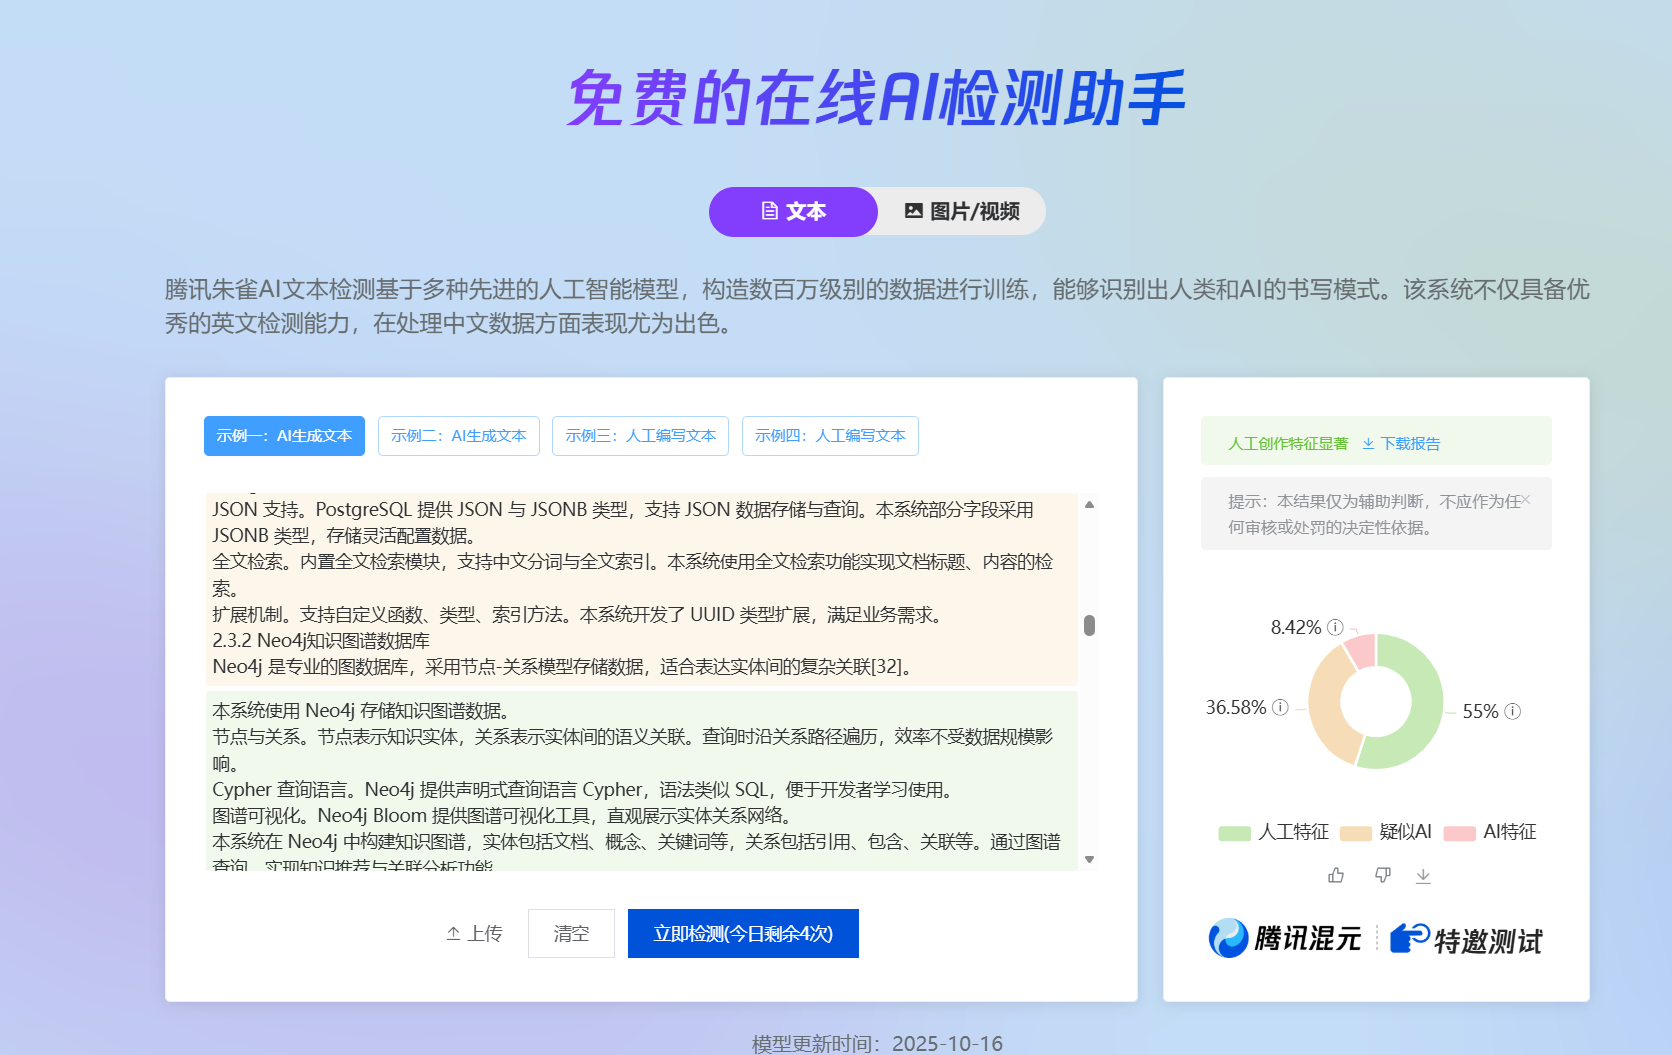
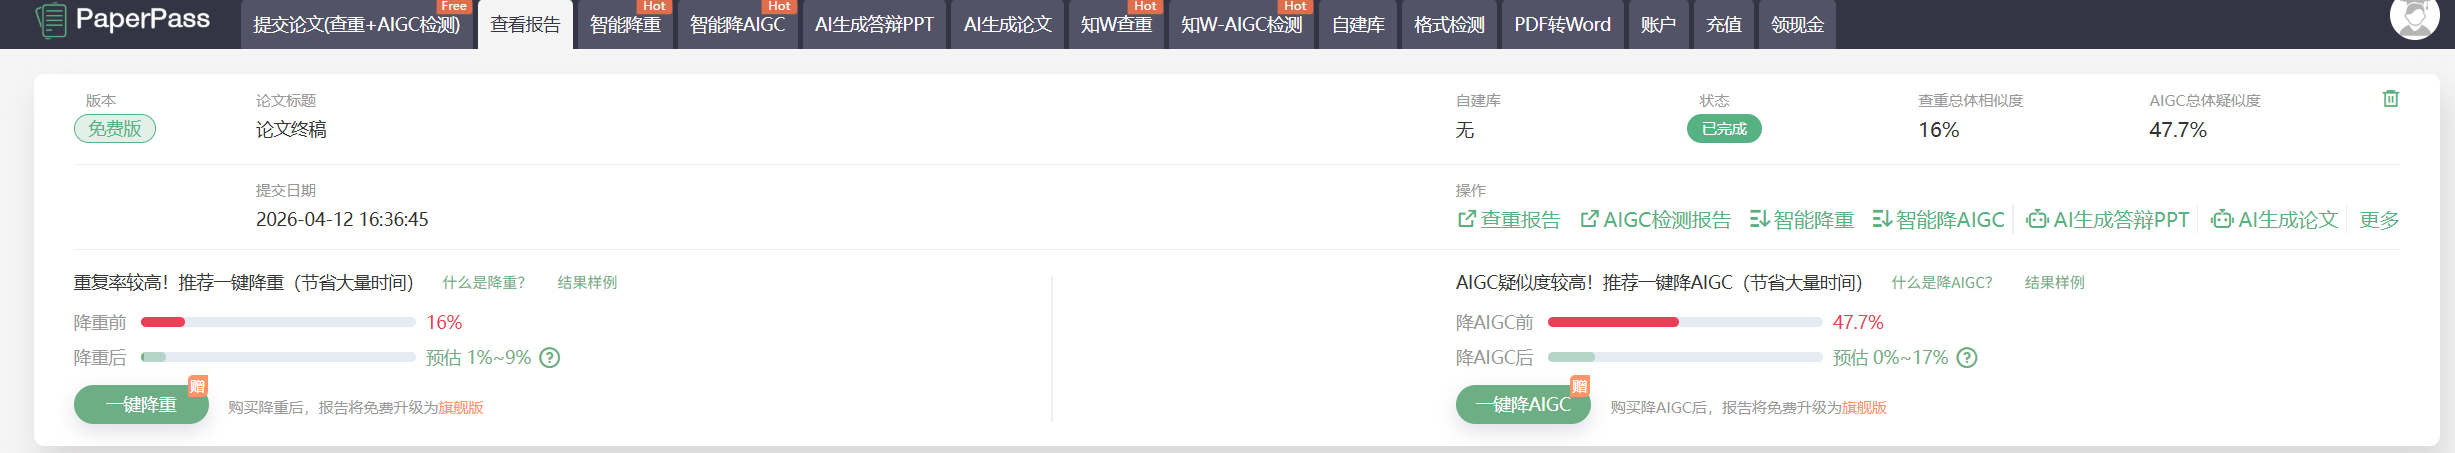
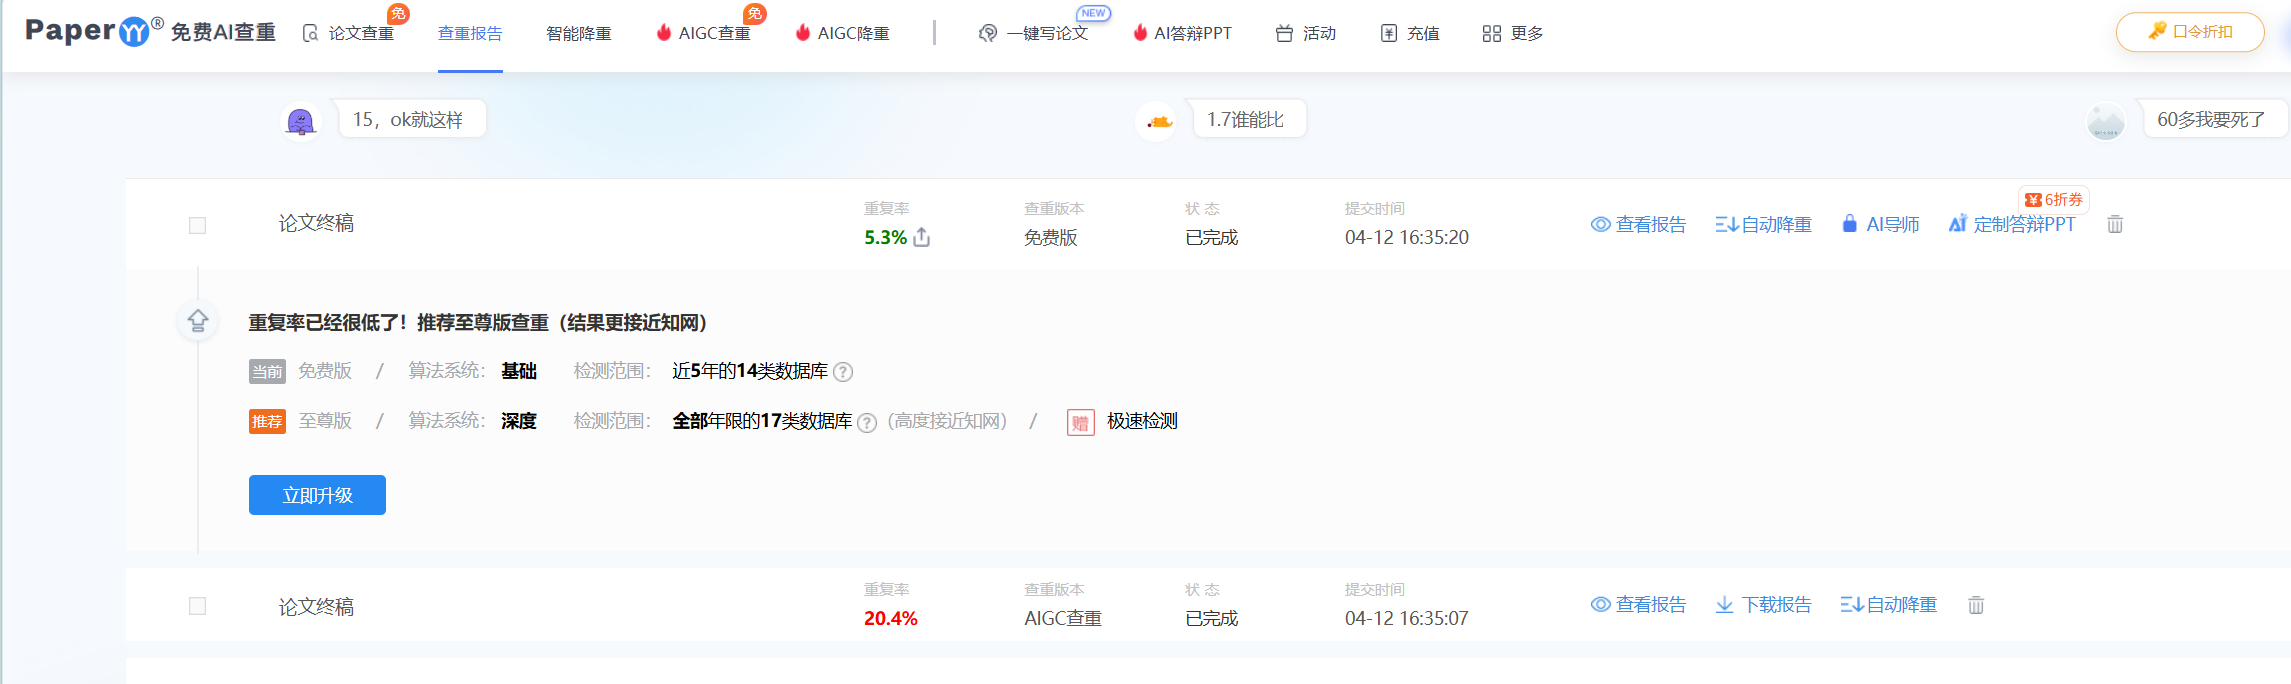
各平台查重及 AIGC 检测结果
朱雀全文检测
PaperPass检测
paperYY检测
快速开始
前置要求
- Python 3.9+
- Claude Code 已安装
- Windows 10/11
安装
方式一:Claude Skill 安装
# 自然语言安装
帮我安装下 skill,项目地址是:https://github.com/Stars-OC/thesis-creator.git

# 从 GitHub 安装
git clone https://github.com/Stars-OC/thesis-creator.git
将文件放入./claude-skills/skills/ 下

# 市场安装 (待进行)
方式二:OpenSkills 安装
使用 OpenSkills 包管理器安装:
# 安装 OpenSkills CLI(如未安装)
pip install openskills

# 或从 GitHub 安装
openskills install https://github.com/Stars-OC/thesis-creator.git
openskills sync
方式三:完整安装(推荐)
包含 Python 工具和依赖:
# 克隆仓库
git clone https://github.com/Stars-OC/thesis-creator.git
cd thesis-creator

# 安装 Python 依赖
.\scripts\install.ps1
# 创建虚拟环境
python -m venv .venv

# 激活虚拟环境
.\.venv\Scripts\Activate.ps1

# 安装依赖
pip install -r scripts\requirements.txt
使用
1. 准备参考资料
references/
├── templates/         # 学校论文格式模板
├── examples/          # 优秀范文
├── guidelines/        # 写作规范
├── prompt/
│   └── background.md  # 论文背景信息(必填)
└── reference/
    ├── code/          # 参考代码
    └── doc/           # 参考文献
2. 触发 Skill
在 Claude Code 中输入:
帮我写论文,主题是《大数据在精准营销中的应用研究》
系统将自动执行完整工作流。
单功能模式
| 触发语 | 功能 | 说明 |
|---|---|---|
帮我降重这段文字:… | 降重优化 | 同义替换、句式重构 |
降低这段的 AIGC 率:… | 人性化改写 | 输出处理前计划、改写文本和清单自检,按场景化重写、自然承接、轻冗余和高密度句拆解处理 |
用成语降重这段文字:… | 成语替换改写 | 侧重成语替换策略 |
检测这段文字的 AIGC 率 | AIGC 检测 | 调用 scripts/aigc/detect.py 本地快速预估 |
帮我生成论文大纲 | 大纲生成 | 根据背景信息生成 |
生成摘要 | 摘要生成 ⭐ | 中英文摘要 + 关键词 |
生成图片 / 生成图表 / 生成架构图 | 图片生成 | AI 图按 Mermaid、Graphviz、PlantUML 生成;架构图生成 source=user 占位并提示用户补图 |
为第X章配图 | 图片生成 | 为指定章节生成图表 |
导出 Word / 导出文档 | 文档导出 | Word + 图片插入 |
导出 PDF | 文档导出 | PDF 格式 |
一键导出 | 图片+文档 | 自动生成图片并导出 Word |
验证文献 / 搜索文献 | 文献验证 ⭐ | 三源搜索 + DOI 验证 |
AIGC 降低策略一览
| 策略层级 | 策略名称 | 说明 | 优先级 |
|---|---|---|---|
| P0 | 场景化重写 | 先判断段落功能,从真实使用场景切入,避免只做词语替换 | 必做 |
| P0 | 自然承接语 | 压缩“因此、此外、综上所述”等模板连接,允许“具体来说、换句话说、放到实际使用里看”等解释型转场 | 必做 |
| P0 | 轻冗余控制 | 删除机械废话,保留少量“通常、往往、也会、在一定程度上”等缓冲词 | 必做 |
| P0 | 高密度句拆解 | 对职责、流程、目标集中在一句内的内容按“抽主干 → 拆动作 → 补解释层”处理 | 必做 |
| P0 | 条款结构保护 | 保留(1)(2)(3)等编号、标题和顺序,只改条款内部表达 | 必做 |
| P1 | 句长波动 | 形成短句点题、长句解释、中句收束的节奏,避免句长过度均匀 | 建议 |
| P1 | 原句骨架重组 | 语义接近前提下调整句序和段内组织,避免机械同义替换 | 建议 |
| P2 | 成语适度使用 | 仅在非技术性总结或维护效果说明处少量使用,技术细节附近不堆砌 | 可选 |
| P2 | 学术边界复核 | 检查是否未新增虚构接口、表结构、实验指标、参考文献或系统能力 | 必做 |
目录结构
File tree
FAQ
thesis-creator is a Claude Code plugin with 1 hand-picked skill for content work, indexed on Flowy. Install it with the command on its page. It includes thesis-creator. Its skills do not fire on their own yet. Request auto-invocation to have Flowy route them as you prompt. Free and open source.
- What is thesis-creator?
- 面向中国本科生的毕业论文全流程写作辅助系统 从选题到交稿,一句话搞定 功能特性 • 快速开始 • 使用文档 •
- How do I install thesis-creator?
- Run these in Claude Code: npx -y skills add Stars-OC/thesis-creator --agent claude-code. Then prompt normally.
- Does thesis-creator auto-invoke its skills?
- Not yet. It is indexed on Flowy as a plain plugin. Request auto-invocation on its page and Flowy will route its skills for you as you prompt.
- Is thesis-creator free?
- Yes. Flowy is free and open source, with nothing gated. You can read every skill in full before you install.
Is this plugin yours?
Claim it with GitHubSubmit a pluginPromote it