
Research
Plugin
paper-fetch-skill
Fetch papers as agent-ready markdown — DOI/URL/title in, structured full text out. CLI · MCP · Skill.

Plugin Signal57/100Fair
maintained99
capable14
documented50
adopted51
Install
$ npx -y skills add dictation354/paper-fetch-skill --agent claude-code
What's inside
README
Paper Fetch Skill
Fetch papers as agent-ready markdown — DOI/URL/title in, structured full text out. CLI · MCP · Skill.
Paper Fetch Skill 是已知论文的 AI 阅读层:输入 DOI、URL 或标题,在你已有合法访问权限的范围内,返回结构化元数据、干净 Markdown 全文和可选图表资源,让 Codex、Claude Code 或任意 MCP host 从“只能读摘要”升级到“可以读全文”。
DOI / URL / title
        ↓
受支持 provider 的官方 HTML/XML → 验证后的 PDF fallback
        ↓
Sections · formulas · tables · references · local assets
        ↓
Markdown · structured article · quality diagnostics
为什么不只是 PDF → Markdown
Paper Fetch 不替代通用 PDF 转换器,而是在它们之外增加论文身份解析、provider 路由、官方结构化全文和统一质量诊断。具体 PDF 工具的能力各不相同;下表比较的是两种设计重点,而不是对所有 PDF 转换器作统一评价。
| 维度 | Paper Fetch | 单一 PDF → Markdown 路径 |
|---|---|---|
| 输入入口 | DOI、URL、标题、arXiv ID 或引用条目 | 已取得的 PDF |
| 首选内容源 | 受支持 provider 优先使用官方 HTML/XML,失败时再走验证后的 PDF fallback | PDF 文本层、版面和 OCR |
| 论文结构 | 统一为 metadata、sections、references、assets 和 quality | 取决于具体转换器及 PDF 版面 |
| 公式 | 源站提供 MathML/TeX 时转换并规范化;失败时保留公式图片或缺失诊断 | PDF 公式恢复能力取决于具体转换器 |
| 图表资源 | 发现、下载、验证、本地链接改写并报告失败或降级 | 图片导出和链接方式取决于具体转换器 |
| References | 全文/出版社 references 优先,保留 raw、DOI、标题和年份等可得字段 | 引用顺序和字段恢复取决于 PDF 版面与工具 |
| 质量可见性 | 区分正文充分性、表格/公式语义损失和资产质量 | 诊断范围取决于具体转换器 |
快速开始
源码 checkout 内安装完整能力并抓取一篇论文:
python -m pip install ".[full]"

paper-fetch fetch \
  --query "10.1186/1471-2105-11-421" \
  --output-dir ./papers
--query 可以是 DOI、论文 landing URL 或标题。未显式传 --output 且指定 --output-dir 时,CLI 会在目录中生成安全命名的主输出;默认 Markdown 模式会保留全文 references,并按 body 资产范围尝试归档正文图表资源。全文不可用时,结果会明确降级为仅摘要、仅元数据或可诊断的失败,而不是伪装成完整正文。
只需要临时把 Markdown 输出到终端、不归档论文资产时:
paper-fetch fetch \
  --query "10.1186/1471-2105-11-421" \
  --format markdown \
  --output - \
  --output-dir ./.paper-fetch-tmp \
  --artifact-mode none \
  --asset-profile none \
  --include-refs all \
  --max-tokens full_text
CLI 默认在终端 stderr 显示逐篇阶段和资产进度;--progress text|jsonl|none 可显式选择输出,--progress jsonl --control-stdin 提供机器单篇/整批取消接口,见 docs/cli.md。
CLI 仍会准备显式工作目录;需要真正无落盘的临时读取时,使用 MCP 临时阅读预设。完整输出和落盘矩阵见 docs/cli.md 与 presets.md。
你会得到什么
- 带 YAML front matter 的论文 Markdown,包含题名、作者、期刊、DOI、来源和正文状态。
- 按源文档恢复的摘要、正文 section、表格、公式、figure caption 和 references。
asset_profile=body|all时可下载的正文或补充资源,以及改写后的本地 Markdown 链接。- JSON、MCP 和 manifest 中统一的 acquisition、content、asset 和 semantic-loss 诊断。
- 当全文、公式、表格或资产不完整时,明确的 warning、质量状态和稳定 reason code。
项目提供三个入口:
| 入口 | 适用场景 |
|---|---|
paper-fetch | 单篇或批量本地抓取与归档 |
paper-fetch-mcp | Codex、Claude Code 等 MCP host 内的结构化调用、缓存和批处理 |
skills/paper-fetch-skill/ | 告诉 agent 何时调用、如何选择预设以及如何验收结果 |
效果展示
agent 安装 skill 后,可以识别 Paper Fetch 的适用边界,并在抓取前确认是否保存全文和图表资源。
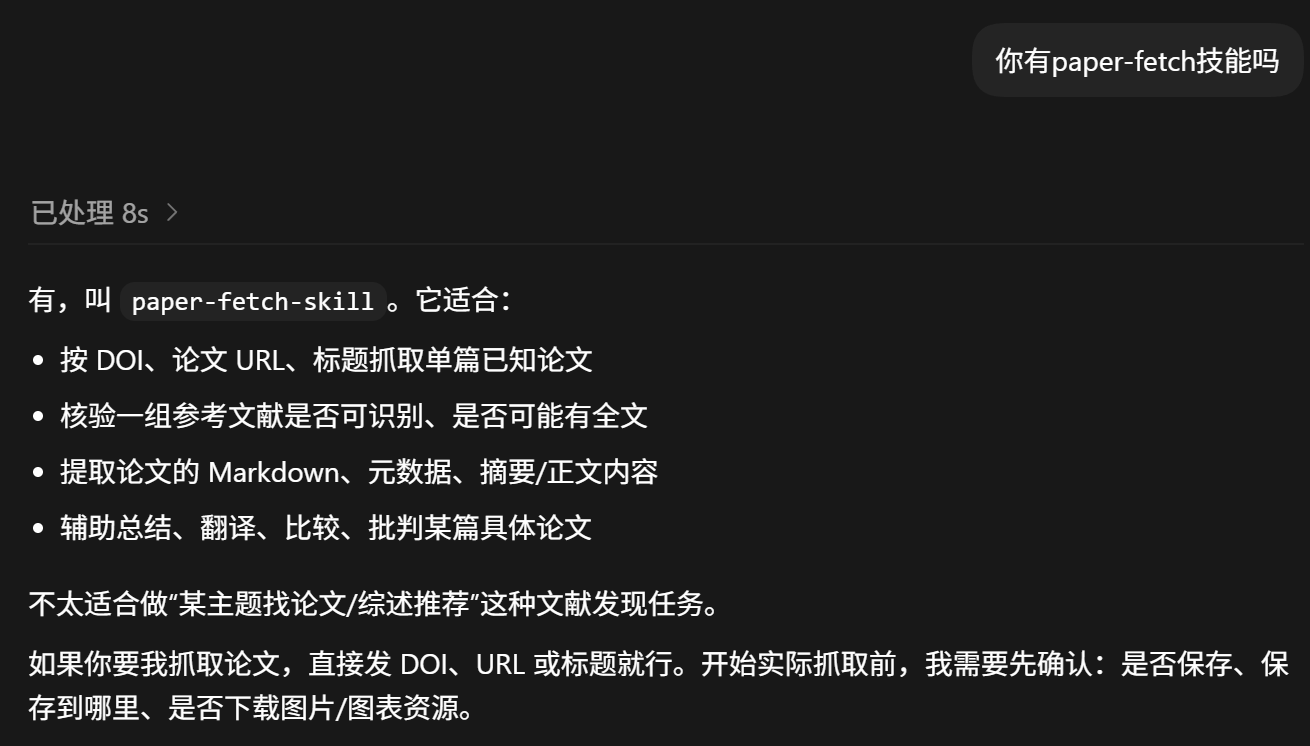
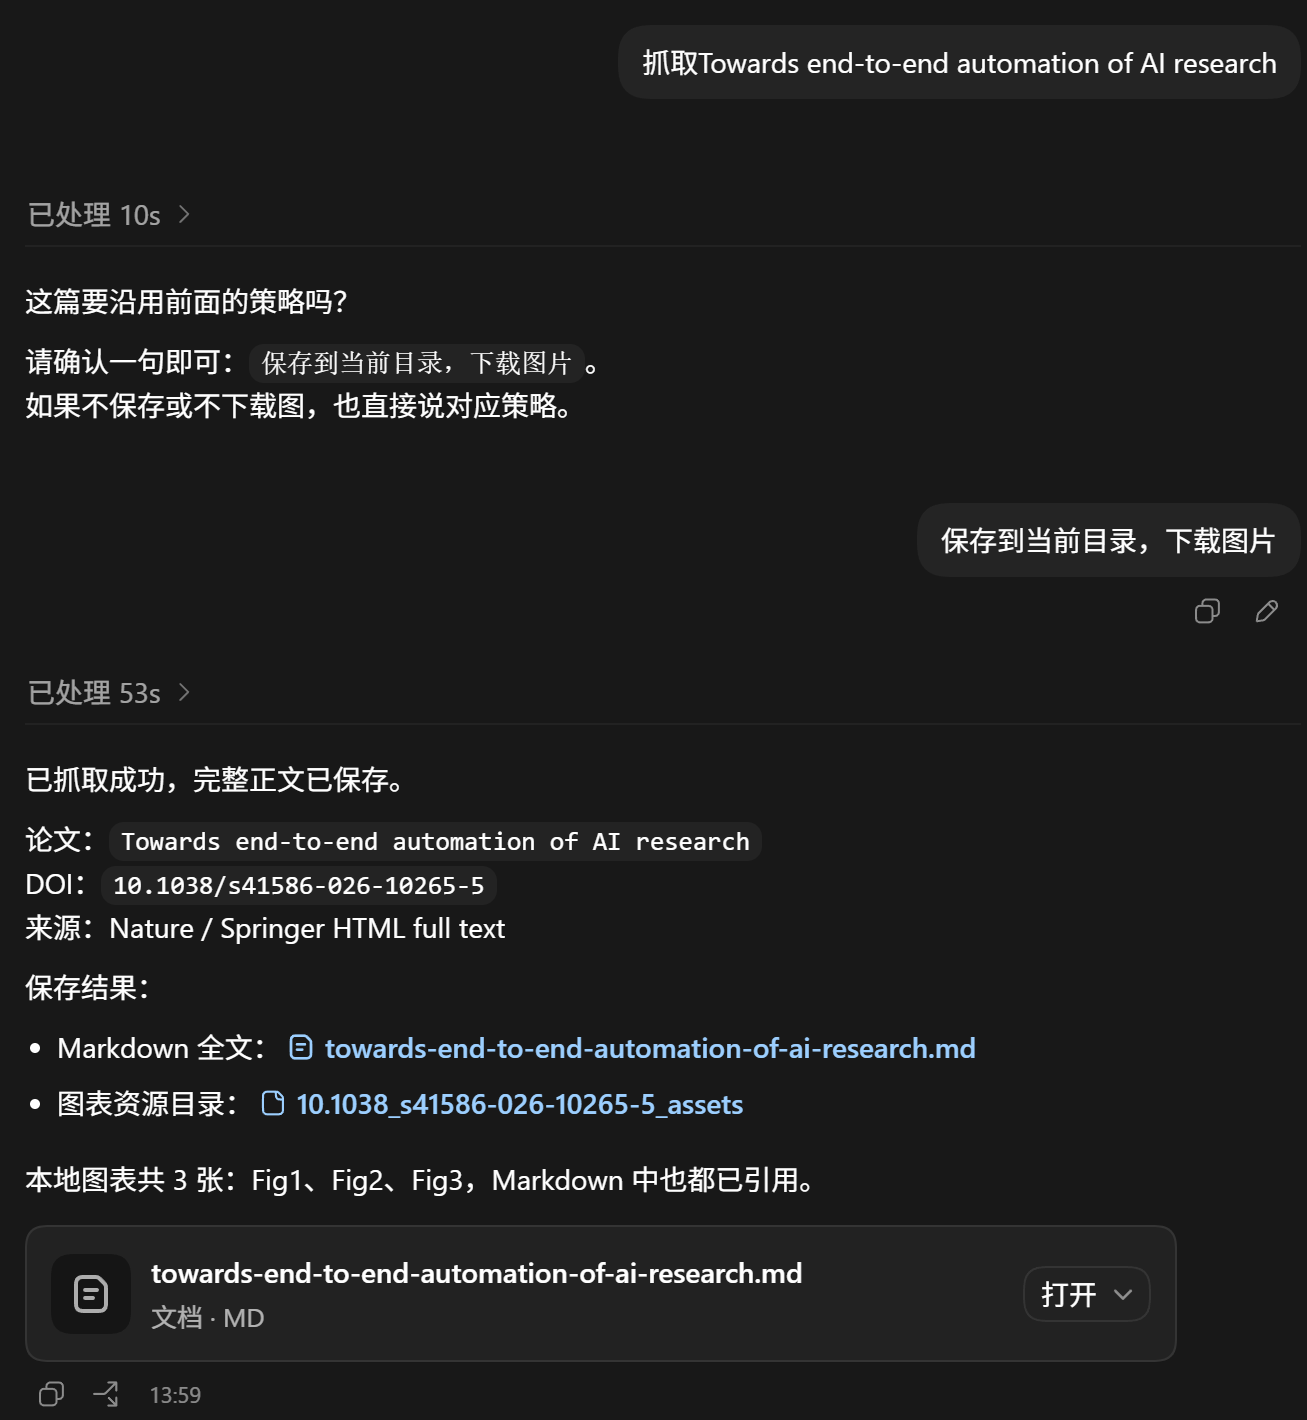
以下示例来自真实开放抓取产物。
Nature 示例
- 论文:Towards end-to-end automation of AI research
- DOI:
10.1038/s41586-026-10265-5 - 来源:Springer/Nature HTML full text
- 许可:
CC BY 4.0 - Markdown 全文:
towards-end-to-end-automation-of-ai-research.md
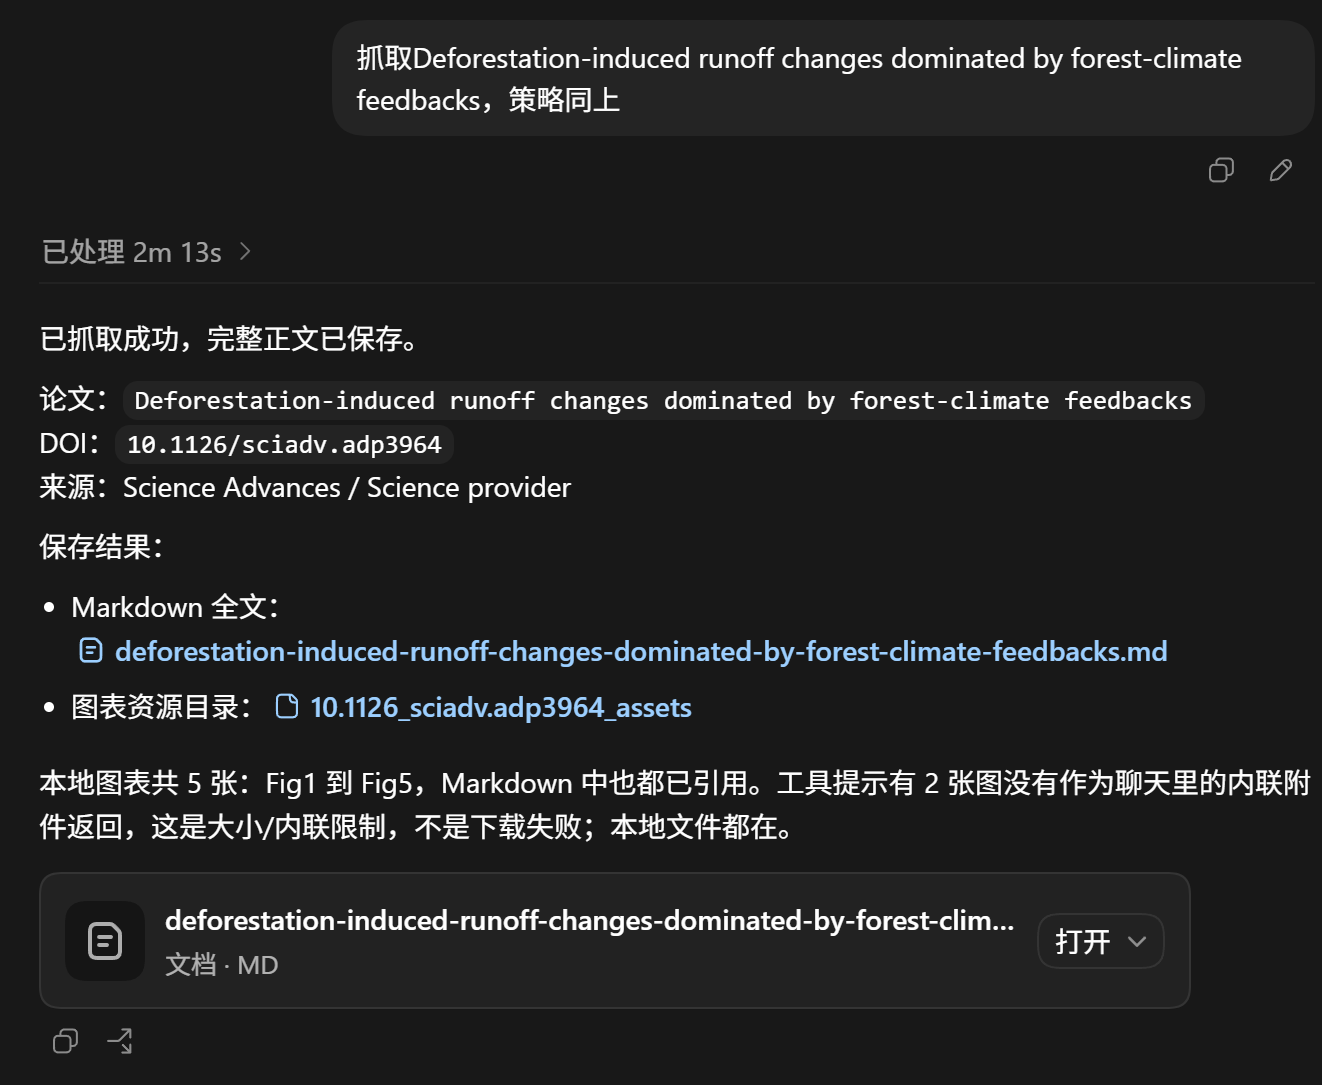
Science Advances 示例
- 论文:Deforestation-induced runoff changes dominated by forest-climate feedbacks
- DOI:
10.1126/sciadv.adp3964 - 来源:Science Advances / Science provider
- Markdown 全文:
deforestation-induced-runoff-changes-dominated-by-forest-climate-feedbacks.md
安装
面向最终用户,推荐从 GitHub Releases 下载离线安装包:
- Windows:
paper-fetch-skill-windows-x86_64-setup.exe - Linux:与本机 CPython ABI 匹配的
paper-fetch-skill-offline-linux-x86_64-cp*.sh - macOS 15+ Apple Silicon:与本机 CPython ABI 匹配的
paper-fetch-skill-offline-macos-arm64-cp*.tar.gz
源码安装按能力分层:
python -m pip install .             # 轻量 core
python -m pip install ".[browser]" # Camoufox/HTML
python -m pip install ".[pdf]"     # PDF fallback
python -m pip install ".[full]"    # browser + PDF
离线包校验、平台矩阵、升级、卸载、Python ABI、Gatekeeper 和 quarantine 处理见 docs/deployment.md。
单篇、批量与 Agent 接入
批量抓取时准备一个每行一个 query 的文件:
10.1186/1471-2105-11-421
https://www.nature.com/articles/s41559-026-03039-9
paper-fetch fetch \
  --query-file ./queries.txt \
  --output-dir ./papers \
  --batch-concurrency 4
批量结果会按输入顺序原子写入 batch-results.jsonl;单篇失败会被记录,不会阻止其它条目继续。需要正文图时使用 --artifact-mode markdown-assets --asset-profile body,需要补充材料时将 asset profile 改为 all。
将本仓库接入 Agent:
| Host | 命令 |
|---|---|
| Codex | ./scripts/install-codex-skill.sh --register-mcp |
| Claude Code | ./scripts/install-claude-skill.sh --register-mcp |
| Antigravity CLI | ./scripts/install-antigravity-skill.sh --register-mcp |
需要自定义环境文件、project/user scope 或手动 MCP 注册时,见 docs/deployment.md。
访问权限与运行时
Paper Fetch 不绕过付费墙或访问授权。可用性取决于 provider、用户凭据、机构访问状态和本机运行环境。
- Elsevier 官方 XML/API 和部分 PDF fallback 需要从 https://dev.elsevier.com/ 申请
ELSEVIER_API_KEY。 - 部分 provider 需要 Camoufox browser runtime 或用户已有的合法登录状态。
- 核心安装不下载 Camoufox binary;离线安装后的可选向导可在用户明确选择后预置。实际启动浏览器前会自动准备 managed runtime;渠道、固定版本、更新失败处理和离线准备见 浏览器安装。
paper-fetch doctor只做本地静态诊断;paper-fetch browser-preflight才会启动浏览器并访问 provider 页面;只有结果明确要求认证时才运行paper-fetch auth <provider>。
paper-fetch doctor
paper-fetch browser-preflight
paper-fetch auth wiley
浏览器后端、认证、显式 runtime 准备和平台限制见 docs/browser-runtime.md 与 docs/browser-backends.md;provider 的当前能力和环境要求见 docs/providers.md。
项目边界
- 只负责已知论文的身份解析、全文获取、验收和报告,不替代开放式主题检索、文献推荐或综述生成。
- 只访问用户本来就有权访问的内容,不绕过 challenge、付费墙或机构权限。
- 官方 HTML/XML、浏览器路径和 PDF fallback 都受 provider、凭据和运行环境限制;“已找到论文”不等于“一定能取得完整全文”。
- 结构化公式转换依赖源站提供 MathML/TeX;只有图片或 PDF 排版信息时,不承诺恢复可靠 LaTeX。
- 新 provider 以 runtime bundle、provider-local 测试和代表性 golden replay 验证获取契约及 HTML/XML 内容;PDF 转换输出保持原样,质量不属于项目修复或验收目标。见
docs/adding-a-provider.md和 PDF 转换边界。
文档
docs/cli.md:CLI 输出、artifact、批量抓取和错误码。docs/deployment.md:安装、配置、MCP 注册和更新。docs/providers.md:provider 路由、能力和环境变量。docs/browser-runtime.md:浏览器运行时、认证和预检。docs/README.md:完整文档导航。docs/architecture/overview.md:架构边界和维护者视角。docs/adding-a-provider.md:添加新 provider。
免责声明
- 获取的文献仅供个人学术研究和学习使用,不得用于商业用途。
- 请遵守所在国家/地区著作权法律法规及所在机构的知识产权政策。
- 本项目不存储、分发或传播任何文献内容,仅协助用户定位、抓取或转换用户有权访问的论文内容。
- fixture 中的文献样本仅作为测试使用,严禁对 fixture 进行任何形式的二次分发。
- 使用者应对自身的文献获取和使用行为承担全部责任。
社区
File tree
FAQ
paper-fetch-skill is a Claude Code plugin with 1 hand-picked skill, indexed on Flowy in the Research category. Install it with the command on its page. It includes paper-fetch-skill. Its skills do not fire on their own yet. Request auto-invocation to have Flowy route them as you prompt. Free and open source.
- What is paper-fetch-skill?
- Fetch papers as agent-ready markdown — DOI/URL/title in, structured full text out. CLI · MCP · Skill. Paper Fetch Skill 是已知论文的 AI 阅读层:输入 DOI、URL 或标题,在你已有合法访问权限的范围内,返回结构化元数据、干净 Markdown 全文和可选图表资源,让 Codex、Claude Code 或任意 MCP host 从“只能读摘要”升级到“可以读全文”。
- How do I install paper-fetch-skill?
- Run these in Claude Code: npx -y skills add dictation354/paper-fetch-skill --agent claude-code. Then prompt normally.
- Does paper-fetch-skill auto-invoke its skills?
- Not yet. It is indexed on Flowy as a plain plugin. Request auto-invocation on its page and Flowy will route its skills for you as you prompt.
- Is paper-fetch-skill free?
- Yes. Flowy is free and open source, with nothing gated. You can read every skill in full before you install.
Is this plugin yours?
Claim it with GitHubSubmit a pluginPromote it